Website Text Extractor — бесплатный инструмент SerpMax для извлечения чистого текста с любой веб-страницы. Введите URL — сервис загрузит HTML, удалит теги, скрипты, стили и служебную разметку, оставив только текст. Без регистрации.
Зачем извлекать текст со страницы
Извлечение текста нужно в шести типовых задачах.
1. Анализ контента конкурентов
Чтобы понять, как конкуренты пишут тексты, нужно получить их в чистом виде. Копировать HTML бессмысленно — там теги, скрипты, разметка. Инструмент извлекает только текст, который можно анализировать.
2. Проверка объёма текста
SEO-стандарт: минимум 300-500 слов для информационной страницы, 1000-2500 для коммерческой. Извлеките текст и проверьте количество слов через проверку количества слов.
3. Контроль уникальности
Если вы заказали текст у копирайтера, извлеките его со страницы и проверьте на уникальность. Так вы убедитесь, что текст не скопирован у конкурента.
4. Извлечение контактов и данных
Если на странице есть email, телефон, адрес — их можно быстро извлечь. Инструмент также показывает открытые email-адреса через проверку email в открытом виде.
5. Подготовка текста для анализа
Чтобы прогнать текст через SEO-анализ, проверку плотности ключевых слов, LSI-семантику — нужно сначала получить чистый текст. Инструмент это делает.
6. Копирование текста без разметки
Если нужно скопировать текст со страницы, но не тянуть с собой HTML-теги, стили и скрипты — используйте экстрактор.
Как пользоваться Website Text Extractor
Проверка занимает несколько секунд.
Шаг 1. Введите URL страницы в поле проверки.
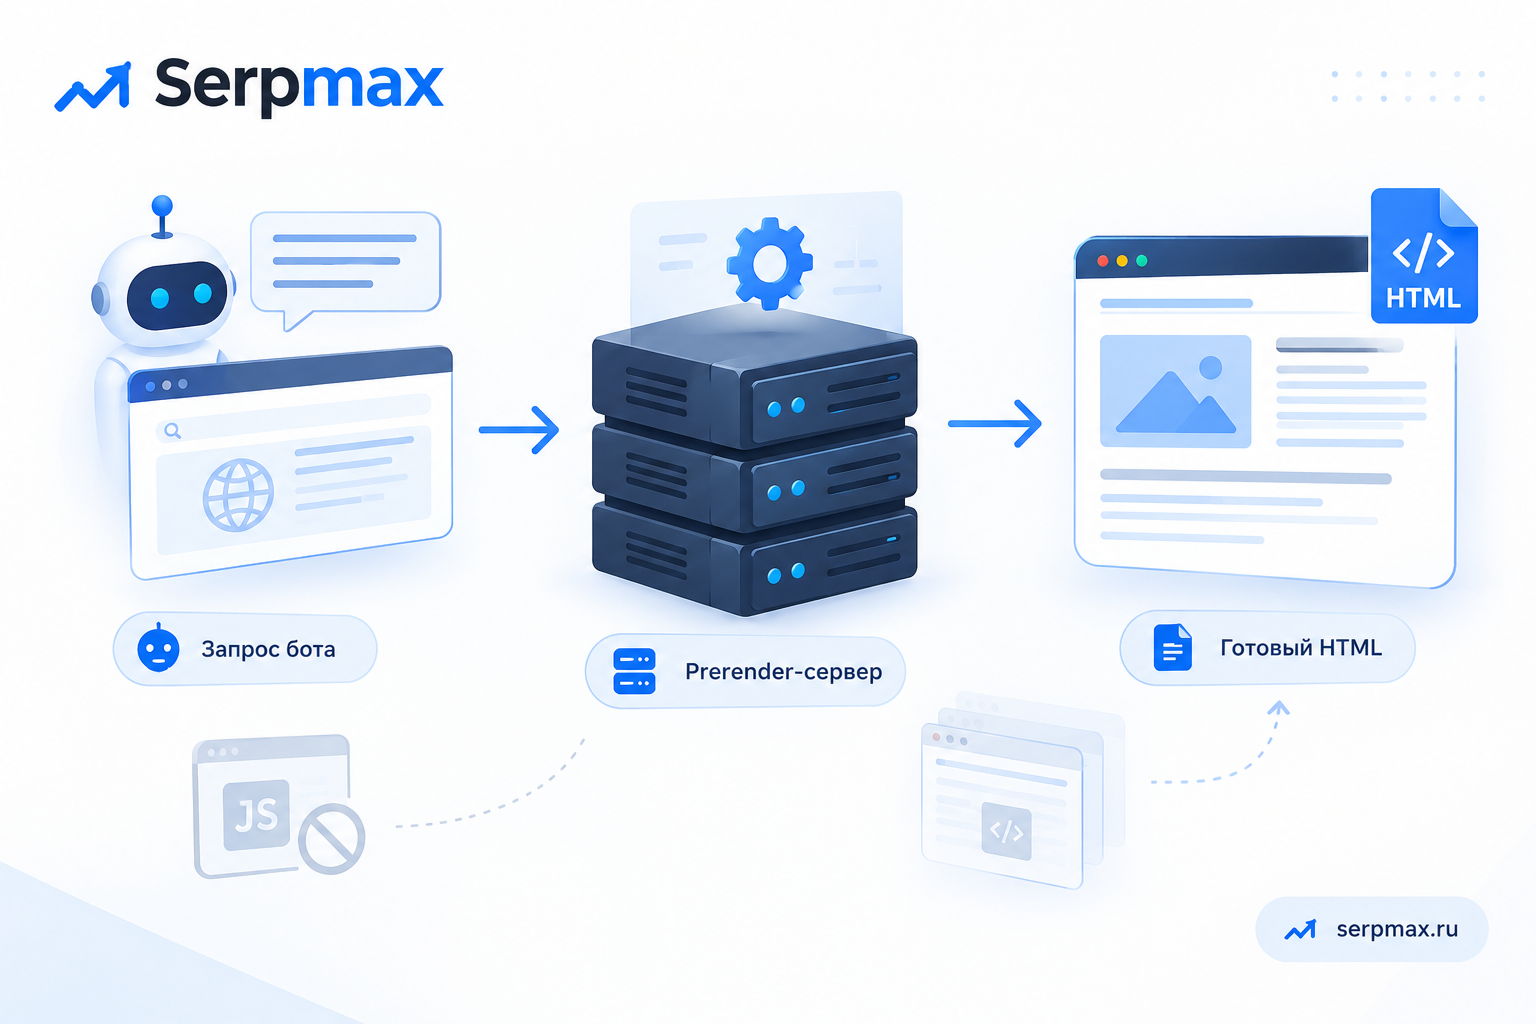
Шаг 2. Нажмите «Извлечь текст». Инструмент загрузит HTML страницы.
Шаг 3. Инструмент удалит:
— HTML-теги;
— скрипты <script>;
— стили <style>;
— комментарии;
— служебную разметку.
Шаг 4. Результат: чистый текст, готовый к копированию или анализу.
Что извлекает инструмент
Инструмент вытаскивает весь видимый текст страницы.
Заголовки. H1, H2, H3 и другие — сохраняются как текст. Это полезно для анализа структуры.
Параграфы. Основной контент страницы.
Списки. Маркированные и нумерованные списки.
Таблицы. Текст из ячеек.
Ссылки. Текст ссылок — без URL.
Кнопки и подписи. Текст на кнопках, в формах, подписях.
Alt-тексты изображений. Если у изображений есть alt — он тоже попадает в результат. Проверить alt-атрибуты можно через проверку alt-атрибутов.
Что НЕ извлекает инструмент
Важно понимать границы.
Текст из JavaScript. Если контент подгружается через JS и не рендерится на сервере — инструмент может его не увидеть. Проверить, видит ли Яндекс JS-контент, можно через Проверку видимости JS-контента.
Текст из изображений. Если текст на картинке — инструмент его не распознает. Для этого нужен OCR.
Текст из PDF. Если контент в PDF-файле — нужен отдельный инструмент.
Скрытый текст. Текст, скрытый через CSS (display:none, visibility:hidden), может не попасть в результат.
Извлечение текста и SEO
Инструмент полезен в нескольких SEO-задачах.
Анализ контента конкурентов. Извлеките текст с 3-5 страниц конкурентов, сравните объём, структуру, ключевые слова. Это даст понимание, какой контент ранжируется в вашей нише.
Проверка собственных страниц. Извлеките текст со своих страниц и проверьте: достаточно ли объёма, нет ли дублей, правильно ли распределены ключевые слова.
Контроль уникальности. Если вы работаете с копирайтерами — извлекайте текст и проверяйте уникальность перед публикацией.
Подготовка к SEO-анализу. Чтобы прогнать текст через проверку плотности ключевых слов или проверку количества слов — сначала извлеките чистый текст.
Чем Website Text Extractor отличается от других инструментов
От HTML Minifier. Минификатор сжимает HTML, но оставляет теги. Экстрактор удаляет теги полностью, оставляя только текст.
От SEO-аудита. SEO-аудит SerpMax проверяет страницу полностью: мета-теги, скорость, безопасность, ссылки. Экстрактор решает одну задачу — извлечение текста.
От копирования вручную. При ручном копировании тянется разметка, ломается структура, теряются абзацы. Экстрактор делает это чисто и быстро.
Как извлечь текст с нескольких страниц
Инструмент работает с одной страницей за раз. Если нужно извлечь текст с нескольких страниц — три варианта.
Вариант 1. Проверяйте страницы по одной. Подходит для 5-10 страниц.
Вариант 2. Используйте SEO-аудит SerpMax — он обходит весь сайт и показывает контент всех страниц. Но это не извлечение текста в чистом виде, а аудит.
Вариант 3. Если нужно массово — используйте API или скрипт. SerpMax предоставляет API для автоматизации.
Где ещё пригодится извлечение текста
Копирайтерам — для анализа конкурентов и проверки своих текстов.
SEO-специалистам — для аудита контента и подготовки к анализу.
Маркетологам — для анализа сообщений конкурентов и подготовки УТП.
Аналитикам — для сбора данных с веб-страниц.
Редакторам — для проверки текстов перед публикацией.
Часто задаваемые вопросы
Website Text Extractor — это бесплатно?
Да, инструмент бесплатный и без регистрации. Можно извлекать текст с любой веб-страницы.
Инструмент извлекает текст со скриптами и стилями?
Нет, инструмент удаляет скрипты, стили, комментарии и HTML-теги. На выходе — только чистый текст.
Можно ли извлечь текст с сайта конкурента?
Да, инструмент работает с любым URL. Это стандартный способ анализа контента конкурентов.
Инструмент сохраняет структуру текста?
Да, абзацы, заголовки, списки сохраняются. Но HTML-разметка удаляется, поэтому визуальное форматирование теряется.
Что делать, если текст не извлекается?
Причины: контент подгружается через JavaScript и не рендерится на сервере; страница закрыта авторизацией; стоит защита от парсинга. Проверьте, видит ли контент Яндекс, через проверку видимости JS-контента.
Можно ли извлечь текст с PDF?
Нет, инструмент работает только с HTML-страницами. Для PDF нужен отдельный OCR-инструмент.
Инструмент извлекает alt-тексты изображений?
Да, если у изображений заполнен alt-атрибут — он попадает в результат. Проверить alt-атрибуты на странице можно через проверку alt-атрибутов.
Как извлечь текст с нескольких страниц сразу?
Инструмент работает с одной страницей за раз. Для массового извлечения используйте API SerpMax или SEO-аудит, который обходит весь сайт.