Noindex — это мета-тег или HTTP-заголовок, который запрещает поисковым системам индексировать страницу. Если noindex установлен по ошибке — страница выпадает из индекса и теряет трафик. В 2026 году это одна из самых частых технических проблем после редизайна или миграции. В этой статье — как проверить noindex на странице, какие инструменты использовать и что делать, если страница закрыта от индексации.
Что такое noindex
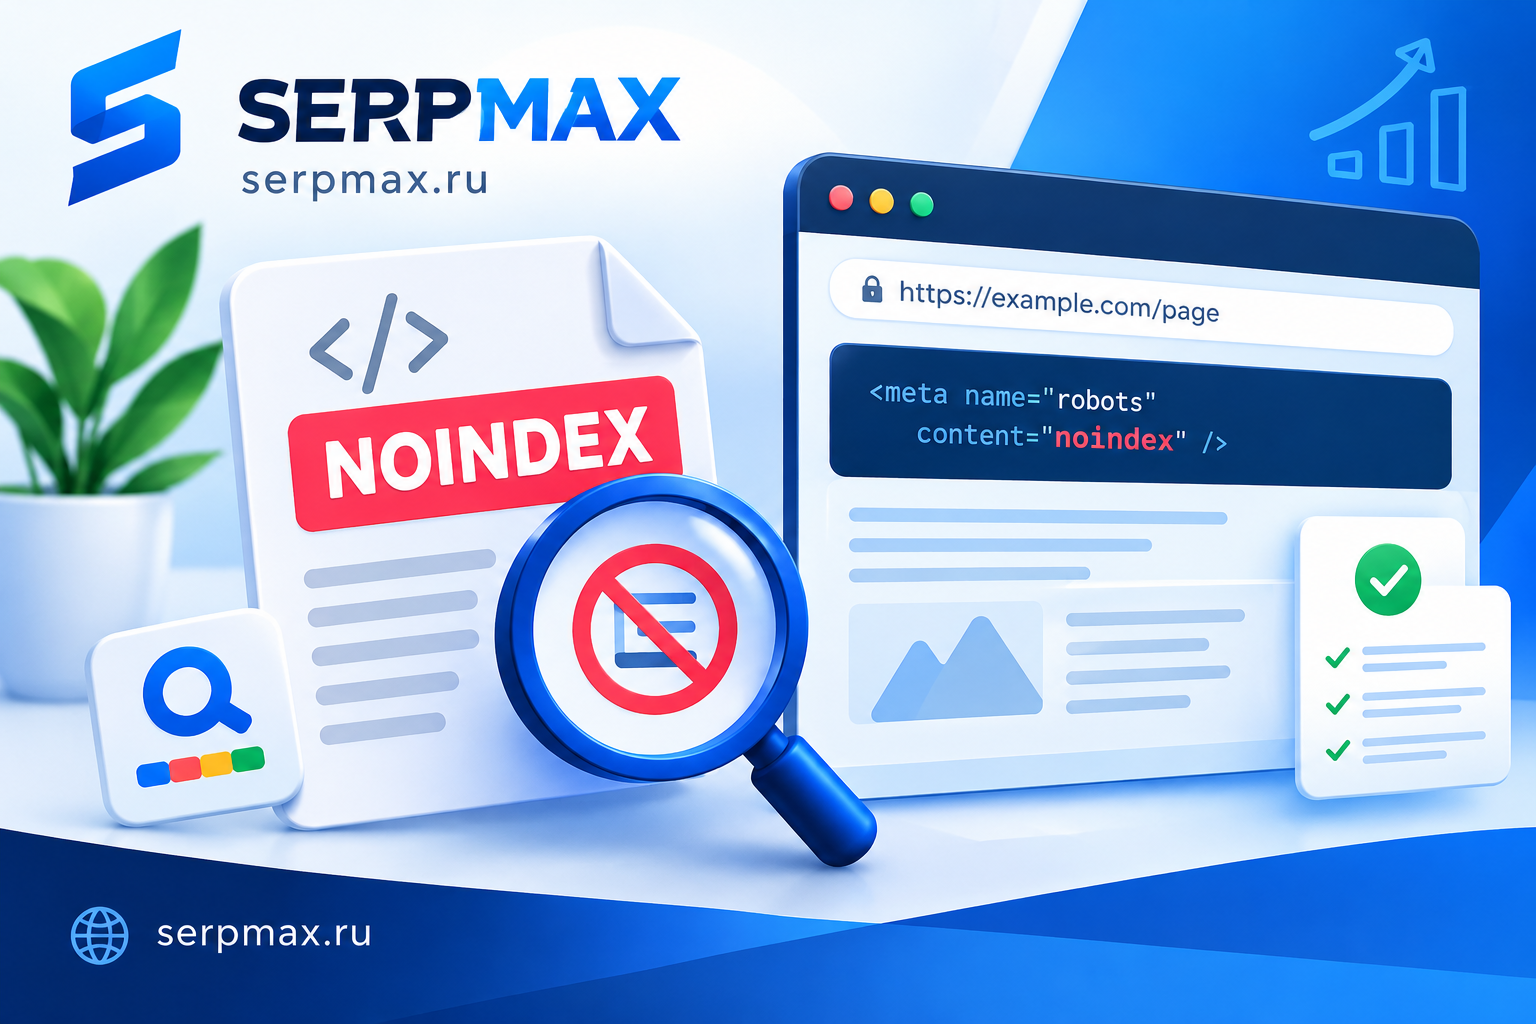
Noindex — это директива для поисковых роботов, которая говорит: «Не включай эту страницу в индекс». Реализуется двумя способами:
1. Мета-тег:
<meta name="robots" content="noindex">
2. HTTP-заголовок:
X-Robots-Tag: noindex
Также есть директива noimageindex, которая запрещает индексацию изображений на странице, но не саму страницу.
Noindex отличается от robots.txt:
— noindex — запрещает индексацию. Страница может быть просканирована, но не попадёт в индекс.
— robots.txt — запрещает сканирование. Страница не сканируется, но может остаться в индексе, если уже там.
Проверить noindex можно через проверку noindex.
Зачем проверять noindex
Три причины.
1. Потеря трафика. Если noindex установлен по ошибке на важной странице — она выпадает из индекса и теряет весь поисковый трафик.
2. Проблемы после редизайна. При редизайне или миграции noindex часто остаётся от тестовой среды. Об этом — в статье Что проверить после редизайна.
3. Контроль индексации. Noindex — инструмент для управления индексацией. Если вы закрываете страницы намеренно — нужно убедиться, что закрыты именно те, что нужно.
Проверка noindex — это часть технического SEO-аудита. О комплексной проверке — в статье Чек-лист технического SEO.
Как проверить noindex
Четыре способа.
Способ 1. Инструмент проверки noindex
Самый быстрый способ — использовать онлайн-инструмент. SerpMax предоставляет проверку noindex — введите URL, и инструмент покажет:
— есть ли мета-тег noindex;
— есть ли HTTP-заголовок X-Robots-Tag с noindex;
— есть ли директива noimageindex;
— рекомендации по исправлению.
Инструмент работает с любым сайтом.
Способ 2. Просмотр кода страницы
Откройте страницу, нажмите «Просмотр кода». Найдите в <head> строку:
<meta name="robots" content="noindex">
Если тег есть — страница закрыта от индексации. Также проверьте, нет ли <meta name="googlebot" content="noindex"> — это отдельная директива для Google.
Способ 3. Chrome DevTools
Откройте Chrome DevTools (F12). Перейдите во вкладку Network. Обновите страницу. Кликните на главный запрос. Перейдите в Headers → Response Headers. Найдите строку X-Robots-Tag.
Если заголовок содержит noindex — страница закрыта от индексации на уровне сервера.
Способ 4. Яндекс.Вебмастер и Google Search Console
Яндекс.Вебмастер: Индексирование → Страницы в поиске. Найдите URL. Если страница исключена по причине «Запрещено в meta-теге robots» — это noindex.
Google Search Console: URL Inspection. Введите URL. Если страница исключена по причине «Excluded by noindex tag» — это noindex.
Это самый надёжный способ, потому что показывает, что видит поисковик.
Почему noindex появляется по ошибке
Пять частых причин.
1. Тестовая среда
Разработчики добавляют noindex на staging-сайт, чтобы он не индексировался. При переносе на продакшн noindex не убирают.
Что делать: проверить noindex на всех ключевых страницах после релиза.
2. Шаблон CMS
Noindex добавлен в шаблон для определённых типов страниц (например, тегов или пагинации), но применяется ко всем.
Что делать: проверить настройки шаблона и SEO-плагина.
3. Настройки SEO-плагина
Плагин настроен на noindex для определённых типов страниц, но настройка слишком широкая.
Что делать: проверить настройки плагина (Yoast, Rank Math, All in One SEO).
4. Миграция
При миграции noindex со старого сайта копируется на новый.
Что делать: проверить noindex после миграции.
5. Случайное добавление
Разработчик добавил noindex для теста и забыл убрать.
Что делать: регулярно проверять noindex на важных страницах.
Как убрать noindex
Если страница закрыта от индексации по ошибке — уберите noindex.
Шаг 1. Найдите, где добавлен noindex: в HTML страницы, в шаблоне CMS или в настройках SEO-плагина.
Шаг 2. Удалите тег noindex или замените на index, follow.
Шаг 3. Если страница была в индексе и потом закрыта — запросите переобход в Яндекс.Вебмастере и Google Search Console.
Шаг 4. Подождите 3-14 дней, пока поисковик переобойдёт страницу и вернёт её в индекс.
Когда noindex нужен
Noindex — не всегда проблема. Его используют намеренно для:
— страниц благодарности;
— результатов внутреннего поиска;
— страниц пагинации (если не хотите их индексировать);
— страниц тегов с тонким контентом;
— staging-сайтов;
— приватных страниц (личный кабинет, корзина).
Проблема не в noindex как таковом, а в noindex на страницах, которые должны быть в индексе.
Noindex для изображений: noimageindex
Отдельная директива noimageindex запрещает индексацию изображений на странице, но не саму страницу:
<meta name="robots" content="noimageindex">
Используйте, если хотите, чтобы страница была в индексе, но её изображения — нет. Проверить через проверку noindex — она показывает и noindex, и noimageindex.
Как проверить noindex на всём сайте
Проверять noindex вручную на каждой странице — долго. Если на сайте 100+ страниц — используйте SEO-аудит SerpMax. Сервис обходит все страницы и показывает:
— страницы с noindex;
— страницы, закрытые через robots.txt;
— страницы с проблемами canonical;
— рекомендации.
Это быстрее, чем проверять каждую страницу отдельно.
Как часто проверять noindex
Рекомендуемая частота:
— после редизайна или миграции — немедленно;
— после обновления CMS или SEO-плагина;
— перед публикацией новой страницы;
— раз в месяц — как часть технического SEO-аудита.
Проверить noindex можно через проверку noindex.
Часто задаваемые вопросы
Что такое noindex?
Noindex — это директива для поисковых роботов, которая запрещает индексировать страницу. Реализуется через мета-тег или HTTP-заголовок X-Robots-Tag.
Как проверить noindex на странице?
Через проверку noindex в SerpMax. Или через просмотр кода страницы. Или через Яндекс.Вебмастер и Google Search Console.
Чем noindex отличается от robots.txt?
Noindex запрещает индексацию, но страница может быть просканирована. Robots.txt запрещает сканирование, но страница может остаться в индексе, если уже там.
Как убрать noindex?
Найдите, где добавлен noindex (HTML, шаблон, плагин), удалите тег или замените на index, follow. Затем запросите переобход в Вебмастере и Search Console.
Что такое noimageindex?
Noimageindex — директива, которая запрещает индексацию изображений на странице, но не саму страницу. Используйте, если хотите, чтобы страница была в индексе, а изображения — нет.
Сколько времени страница возвращается в индекс после снятия noindex?
Обычно 3-14 дней. Если страница была в индексе раньше — может вернуться быстрее. Если сайт молодой — дольше. Запросите переобход для ускорения.
Почему noindex появился по ошибке?
Частые причины: тестовая среда, шаблон CMS, настройки SEO-плагина, миграция, случайное добавление. Проверяйте noindex после редизайна и миграции.
Как часто проверять noindex?
После редизайна или миграции, после обновления CMS, перед публикацией новых страниц, раз в месяц как часть технического SEO-аудита.